从单神经元
到卷积
文献读到激活函数那一节,代码从最笨的模型一路加到 225 个参数。 这周想弄清楚的是:加参数、加非线性,各自到底管什么用。
研究背景
读的是马永杰 2021 那篇综述:交通运输工程学报 21(4): 48–71,146 篇参考文献。 它把卷积神经网络在智能交通里的应用梳理成五类——车牌、车型、交通标志、交通事件、交通状态预测。
框架是清楚的。但卷积层内部到底怎么算,综述只给结论不给过程, 读完还是没底。所以决定先自己实现一遍,再回头看那几节。
读到激活函数时,顺手把整个结构整理成了一份笔记:卷积层提取局部特征, 同一张特征图里的神经元共享权重;池化层跟在卷积层后面做降采样,防止特征维度过高, 方法分基于值、概率、等级、转换域四类;激活函数提供非线性,常用 Sigmoid、Tanh、ReLU; 训练是前向算每层状态、算误差、反向传播、对权重和偏置求导这四步。
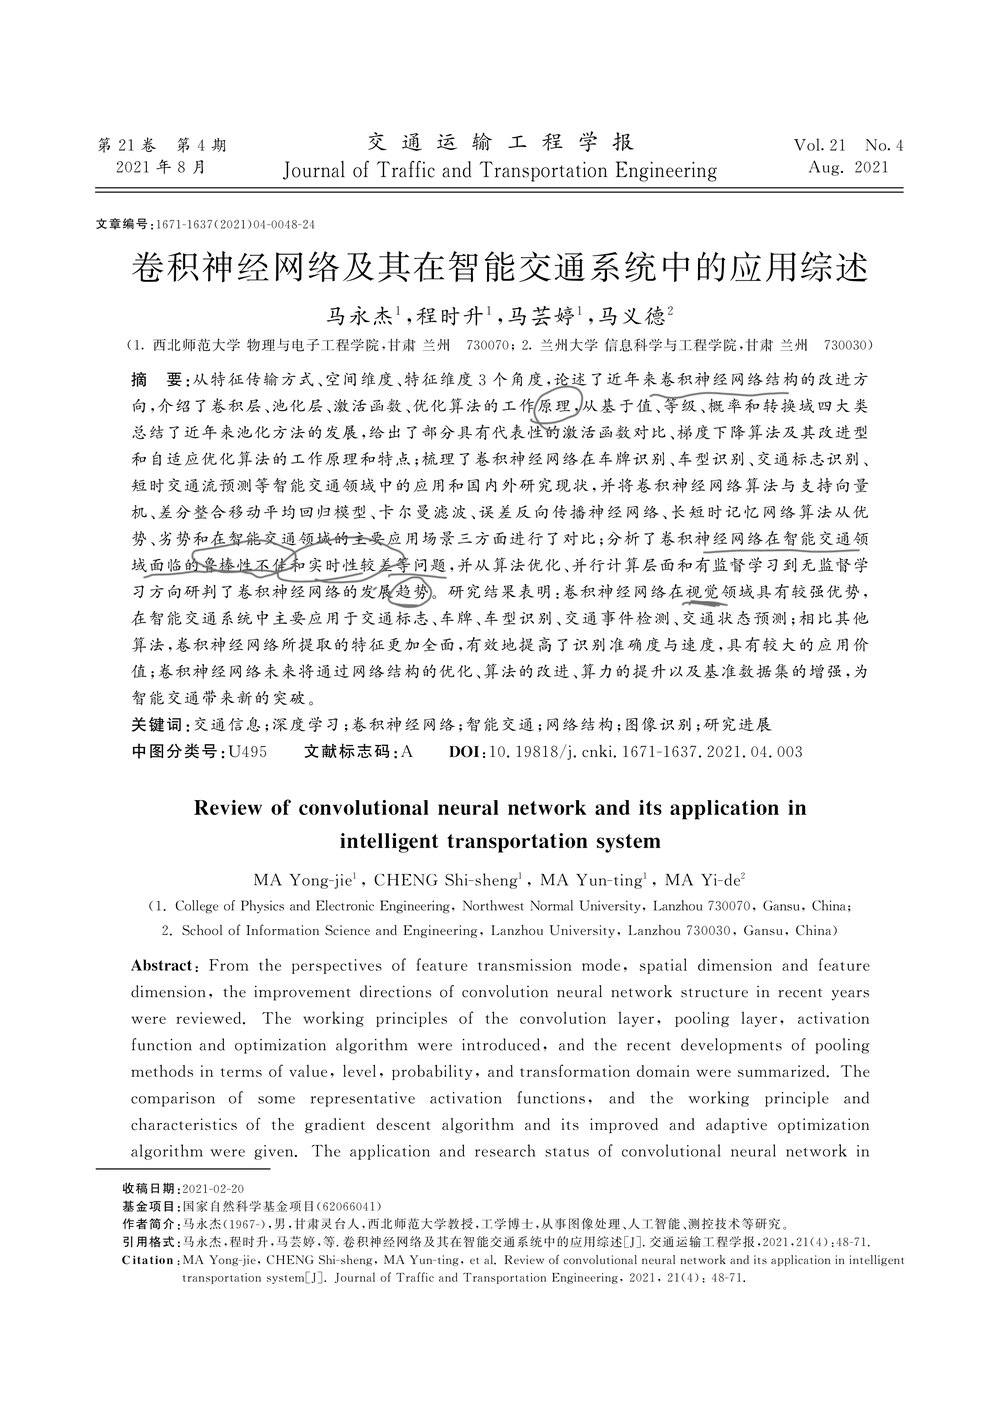
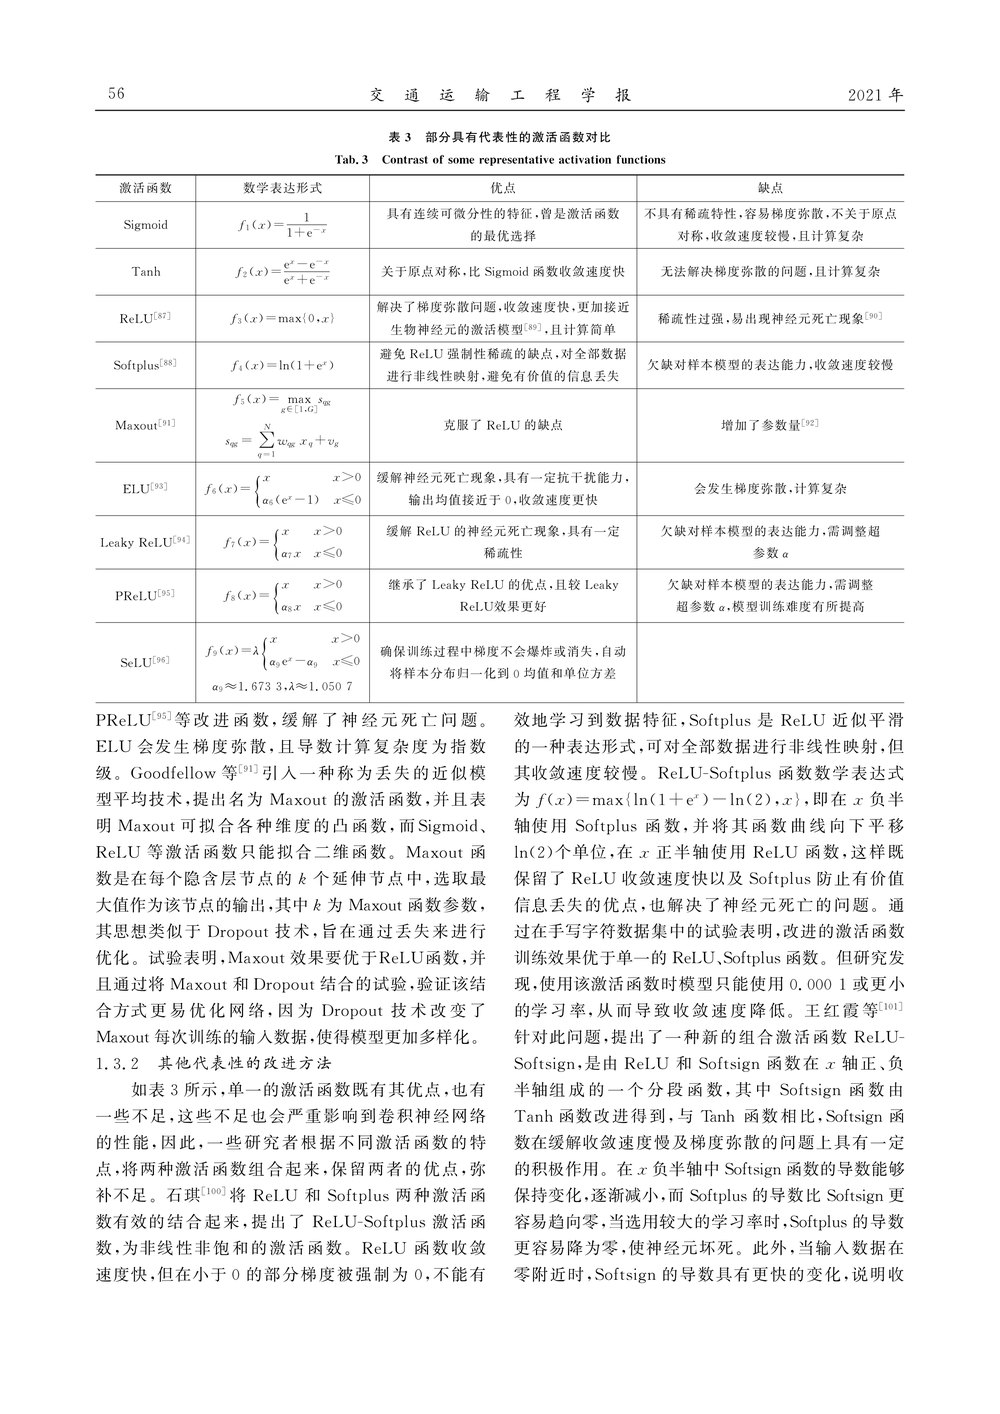
五类应用里,只有「交通状态预测」跟信号交叉口方向对得上,其余四类偏视觉识别。 下周打算把田秀娟 2018 和 2025 那篇信号交叉口的论文补上。
要动手,得先找一份能跑的数据。
数据来源
手上三个数据集。SUMO 是仿真器导出的单路口记录,本来想用它看数据格式;
CN+ 是唯一一份真实路口检测数据,15022 条、14 个进口道,但 23 天里只有零散片段,接不成序列;
CityFlow 有 100 个路口、3 个月、小时级,序列最长,所以选它的 INT_001 做实验。
这是练手的选择,不是研究的选择。用之前我先简单测了一下 CityFlow,做了三个检查。
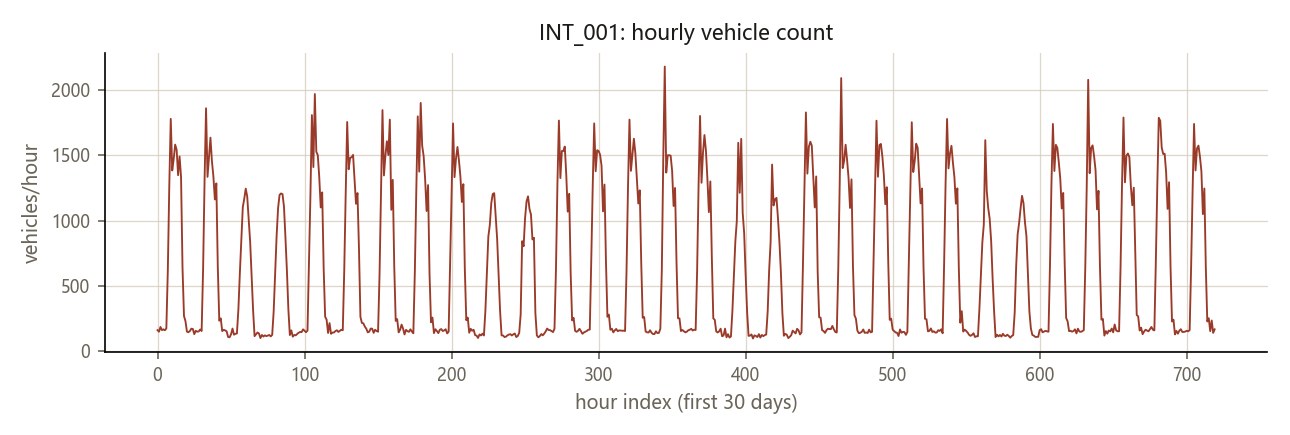
取 30 天看,是很规整的昼夜周期,每天两个高峰。峰值能到 3000 以上。
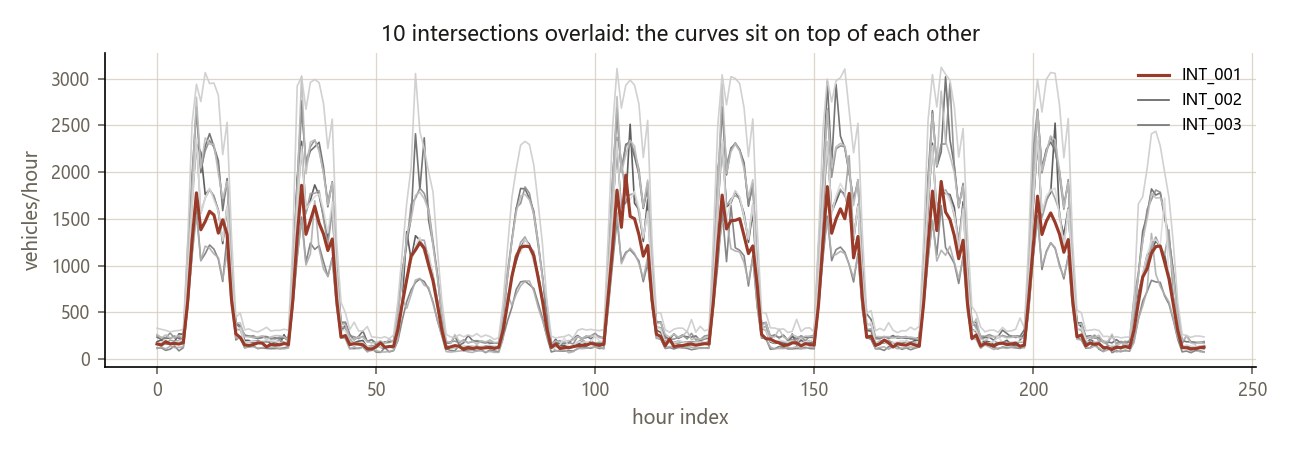
形状完全一样,只是整体上下缩放。说明这 100 个路口是同一个模板生成的。
两两相关系数均值 0.9870,最低 0.9783,最高的 0.9957。 100% 的组合都在 0.8 以上。图里几乎全是同一个色阶。
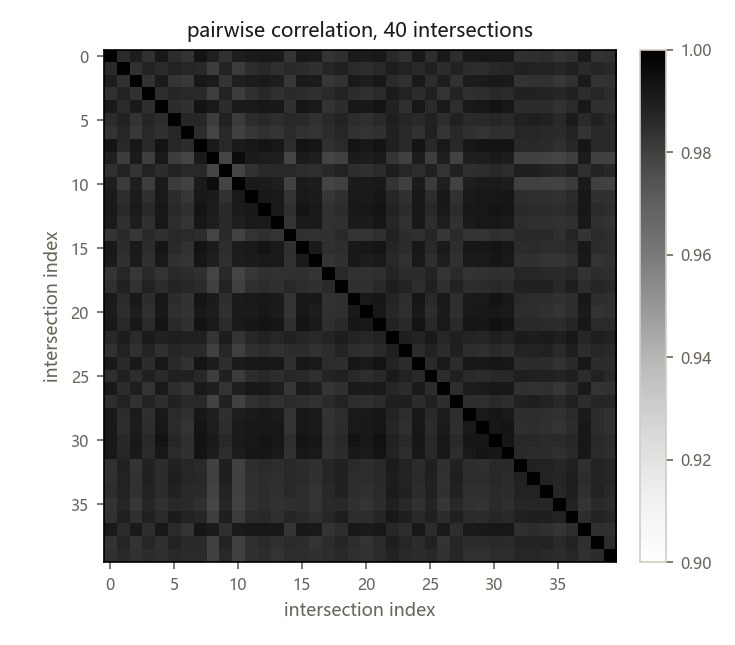
三个检查指向同一件事:这个数据集没有空间结构,做不了多路口建模。
另外它虽然带 signal_cycle_seconds、green_light_duration、queue_length
这些字段,看上去正好对上信号交叉口,但都是小时级聚合后的合成值,做不了分钟级分析。
数据既然只能练流程,那就从最笨的模型开始搭。
模型递进
数据集用 CityFlow 里的 INT_001,一共 2040 个连续小时点。
用滑动窗口切成 2028 个样本:每个样本取连续 12 个小时的车辆数当输入,
紧跟着的那 1 个小时当答案。
按时间顺序切成三段,不打乱:前 1419 个训练,接着 202 个验证,最后 407 个测试。 标准化用的均值和标准差只从训练集算,验证集和测试集用同一组数换算。
四个模型的输入输出完全一样,区别只在内部怎么把 12 个数变成一个数: 朴素预测直接取最后一个数;单神经元给最后一个数配一个权重和一个偏置; 线性回归给 12 个数各配一个权重;两层 MLP 先把 12 个数升到 16 维、过一道 ReLU,再压回 1 维。
| 模型 | 参数 | MAE | RMSE | MAPE |
|---|---|---|---|---|
| 朴素预测:拿上一小时直接用 | 0 | 160.49 | 253.05 | 29.50% |
单神经元:y = w·x₁₂ + b |
2 | 169.58 | 246.76 | 39.16% |
| 线性回归:12 个输入加权求和 | 13 | 153.25 | 196.93 | 49.10% |
| 两层 MLP:12 → 16 → 1,中间有 ReLU | 225 | 57.54 | 90.93 | 19.45% |
MAE、RMSE 单位是辆/小时。学习率 0.05,最多 6000 轮,验证集连续 200 轮不降就停。
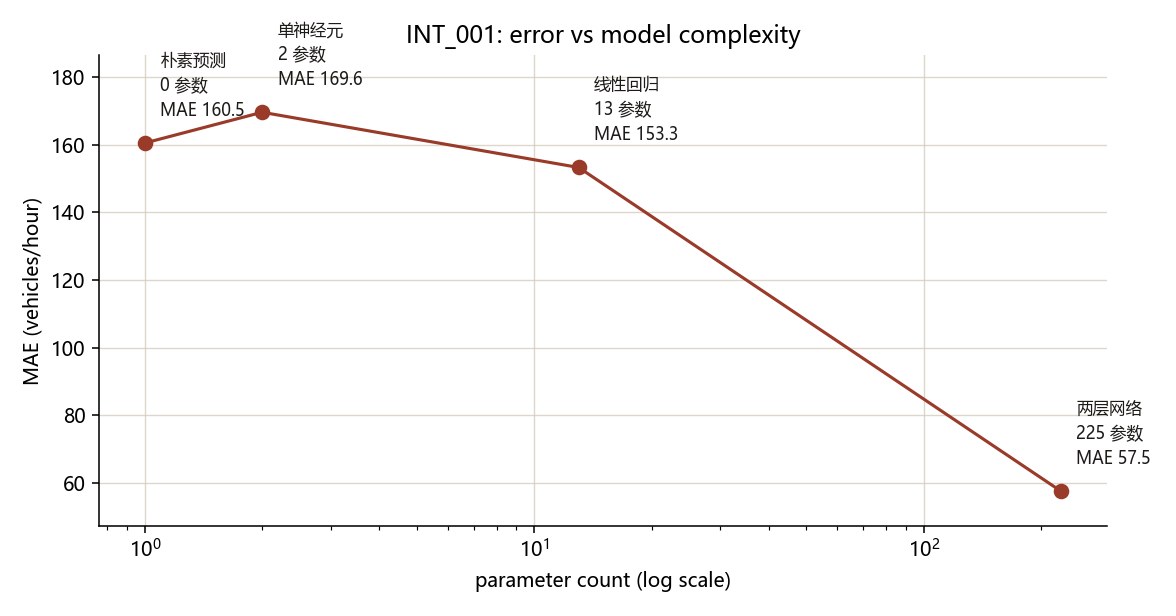
加 2 个参数,反而比不加更差。加到 13 个,只比朴素预测好了 7 辆。 一直到加了隐藏层和非线性,才出现断层式的下降。
这批结果能推广到哪
那前面这三级到底在干什么,为什么加了参数反而更差?
误差机制
把四个模型拆开看,前三个其实在做同一件事。 上一小时的流量和下一小时的相关系数是 0.9016,本来就是最强的预测因子, 但它们的权重都不是原样传下去。
只有一个权重,训练完是 0.8978,偏置约等于 0。 意思是「把上一小时的值打九折」。
打九折之后,大误差被压小了(RMSE 从 253.05 降到 246.76), 但普通点的误差反而变大(MAE 从 160.49 涨到 169.58)。 这就是收缩估计的典型代价。
其中上一小时的权重是 0.9949,看着像「照抄」。 但其余 11 个权重有正有负,净贡献是 −0.4474。 合起来,这个模型对输入的响应强度只有一半。
所以它不是「抄上一小时」,是一个收缩的滞后模型: 稳态下预测值只有真实值的一半,会被拉向训练均值 617。 低流量时段真实只有一两百,它还在报几百,百分比误差就上去了。
按真实流量分档看百分比误差:
| 真实流量(辆/小时) | 样本 | 朴素 | 单神经元 | 线性 | 两层 MLP |
|---|---|---|---|---|---|
| 0 – 300 | 219 | 28.0 | 47.8 | 74.5 | 28.8 |
| 300 – 600 | 12 | 61.7 | 54.8 | 35.1 | 12.4 |
| 600 – 1000 | 38 | 69.2 | 62.2 | 33.9 | 23.4 |
| 1000 以上 | 138 | 18.1 | 17.7 | 14.3 | 4.1 |
0–300 档占测试集一半以上。两层 MLP 在这一档是 28.8%, 朴素预测 28.0%——只是追平,没有超过。 它真正的优势在 1000 以上那档,4.1% 对 18.1%。
所以准确的说法是:非线性的价值不在「修好低流量」,而在 让模型有余力同时拟合低流量和高流量两种形态。 线性模型只有一条斜率,MLP 可以分段。
到这里,全连接网络能做的都做完了。那卷积呢?
卷积验证
回到文献里没读懂的那部分。卷积层和全连接层最大的差别是权重共享: 一个 3×3 的核只有 9 个权重,却要在整张图上反复用。
为了看清楚这件事,我画了两张交通示意图做前向验证:一张车牌,横平竖直; 一张路面标线,带斜向车道线和水平停止线。这里没有训练, 四个核是人工指定的经典算子,只做前向计算。
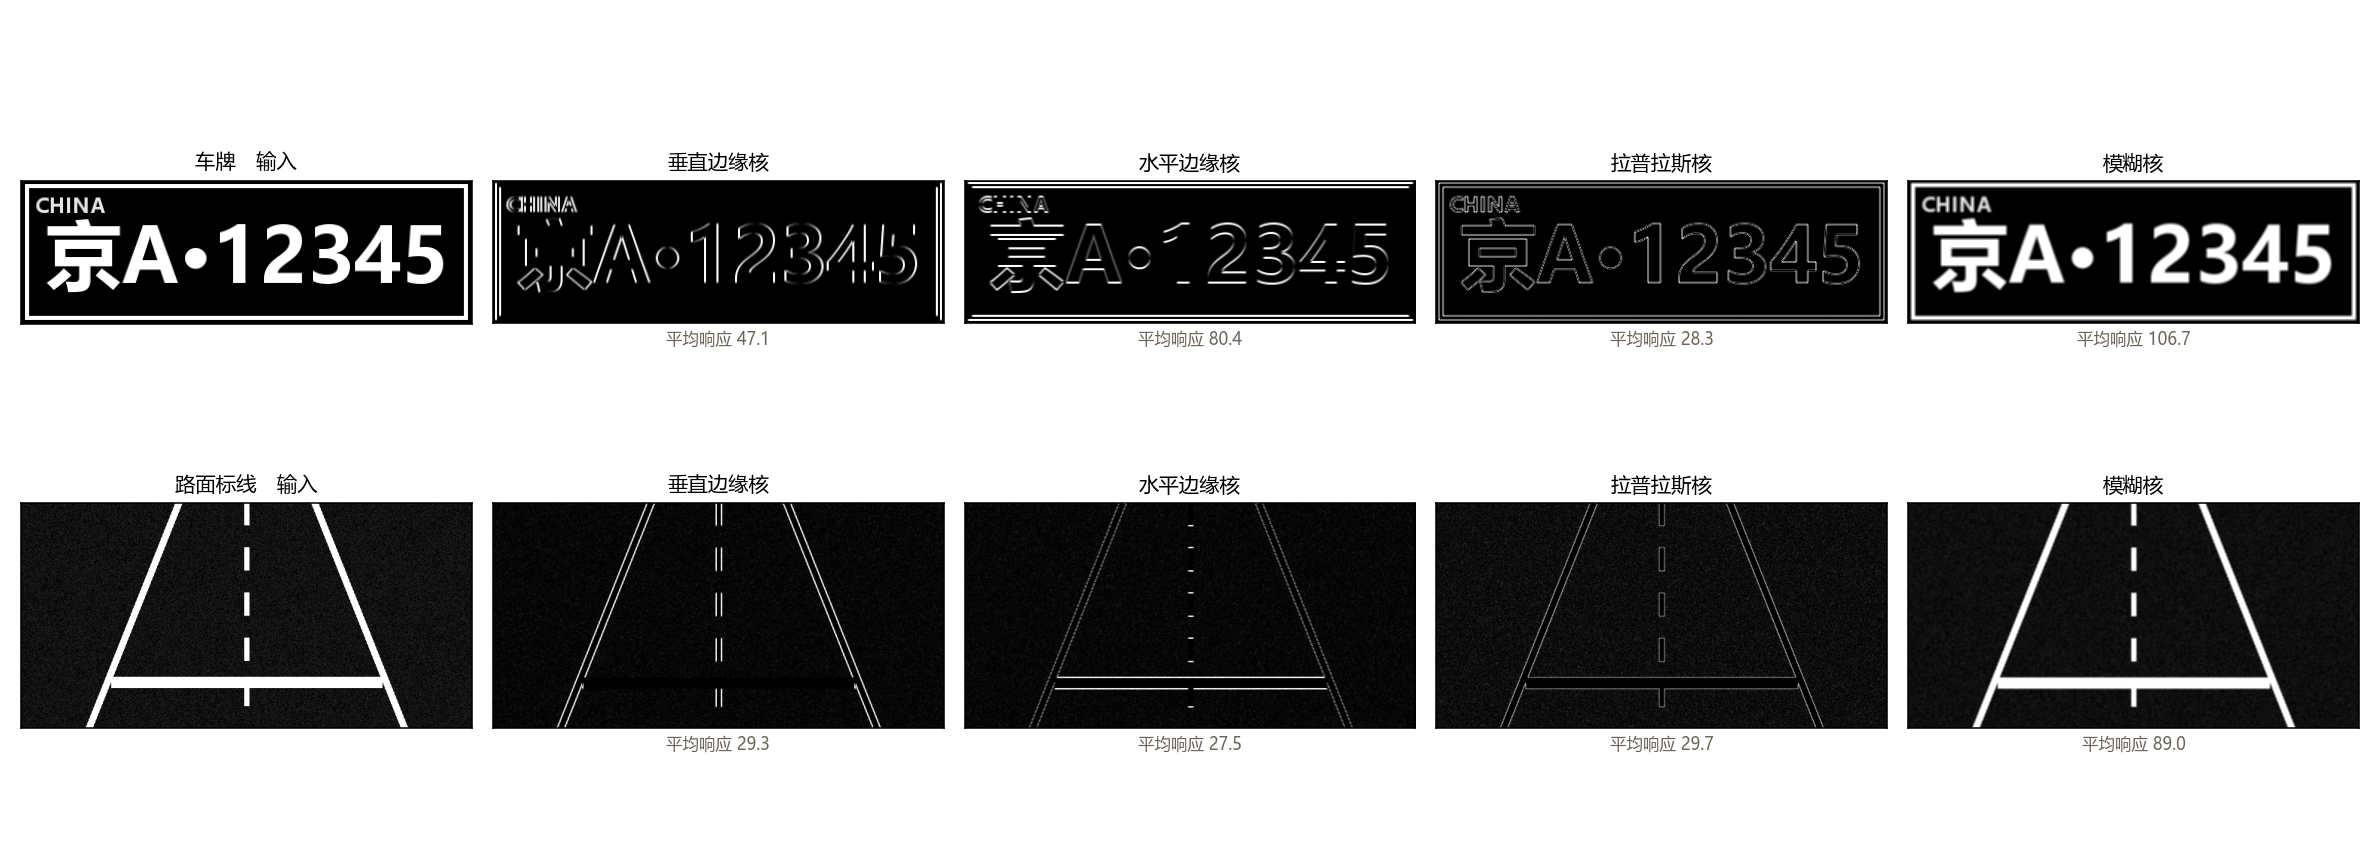
结果能对上预期。车牌以横线为主——边框、京字的横、数字的横笔—— 所以水平核的平均响应 80.4,明显高于垂直核的 47.1。 路面的车道线是斜的,垂直和水平两个方向的响应就差不多,29.3 对 27.5, 反而是拉普拉斯核把整条轮廓完整抓了下来。
这说明一个核就是一个特定的「模式探测器」:它只对某一方向的亮度变化敏感。 卷积层放几十个核,就是同时派几十个探测器去找几十种不同的模式。
换成训练出来的核和真实照片
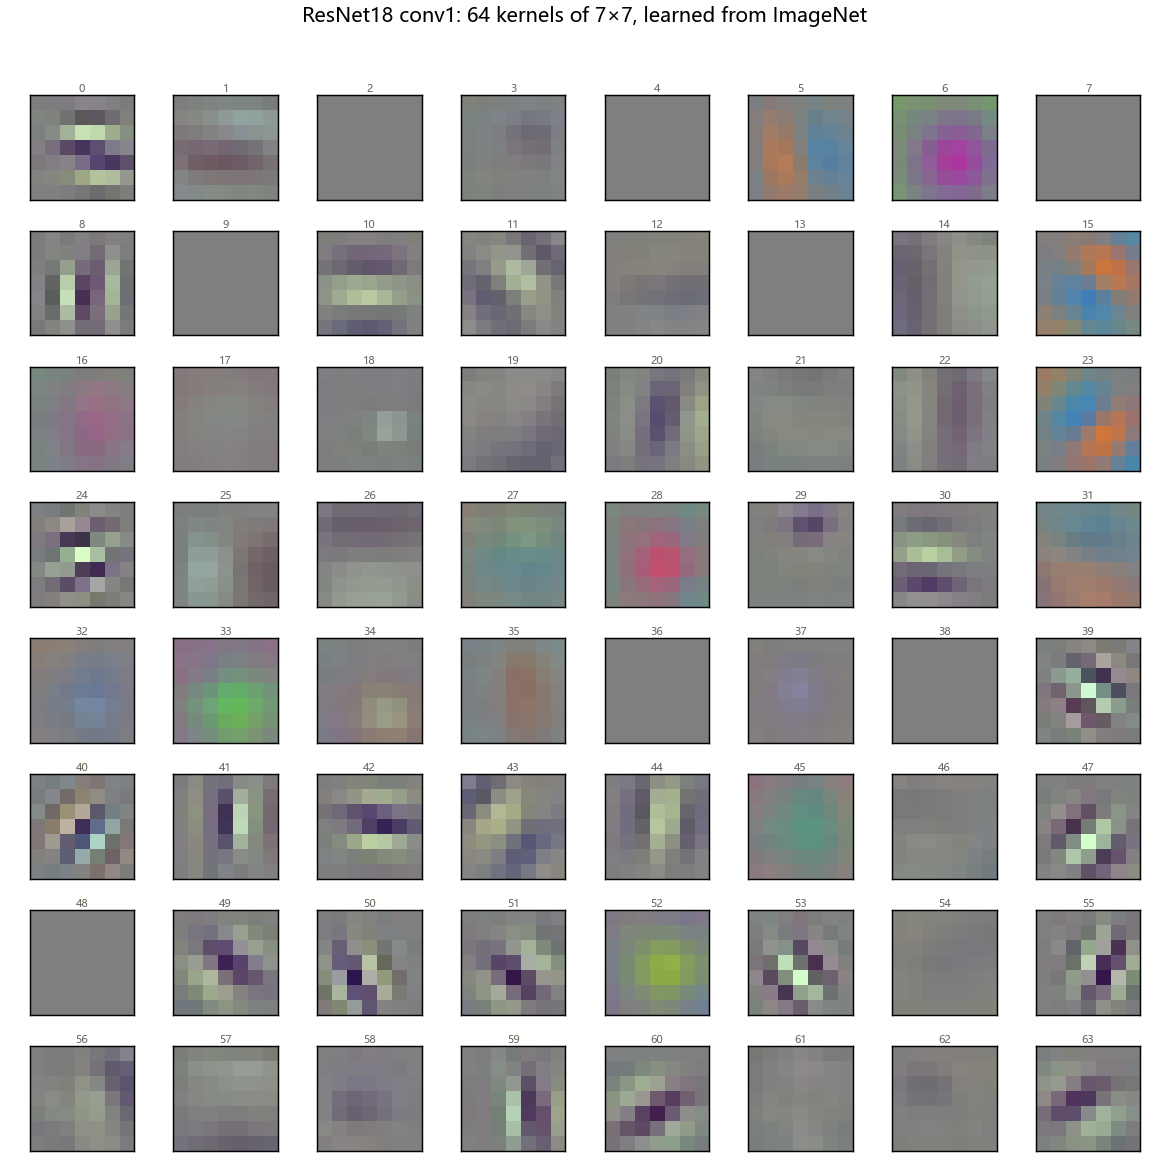
上面的四个核是我指定的,图片也是我画的。换成真实的一整套: 加载 ResNet18,在 ImageNet 上训练过的网络,第一层有 64 个 7×7 的卷积核,没有任何人告诉它们该去找什么。 照片来自 Wikimedia,真实道路场景,CC BY-SA 4.0 授权。
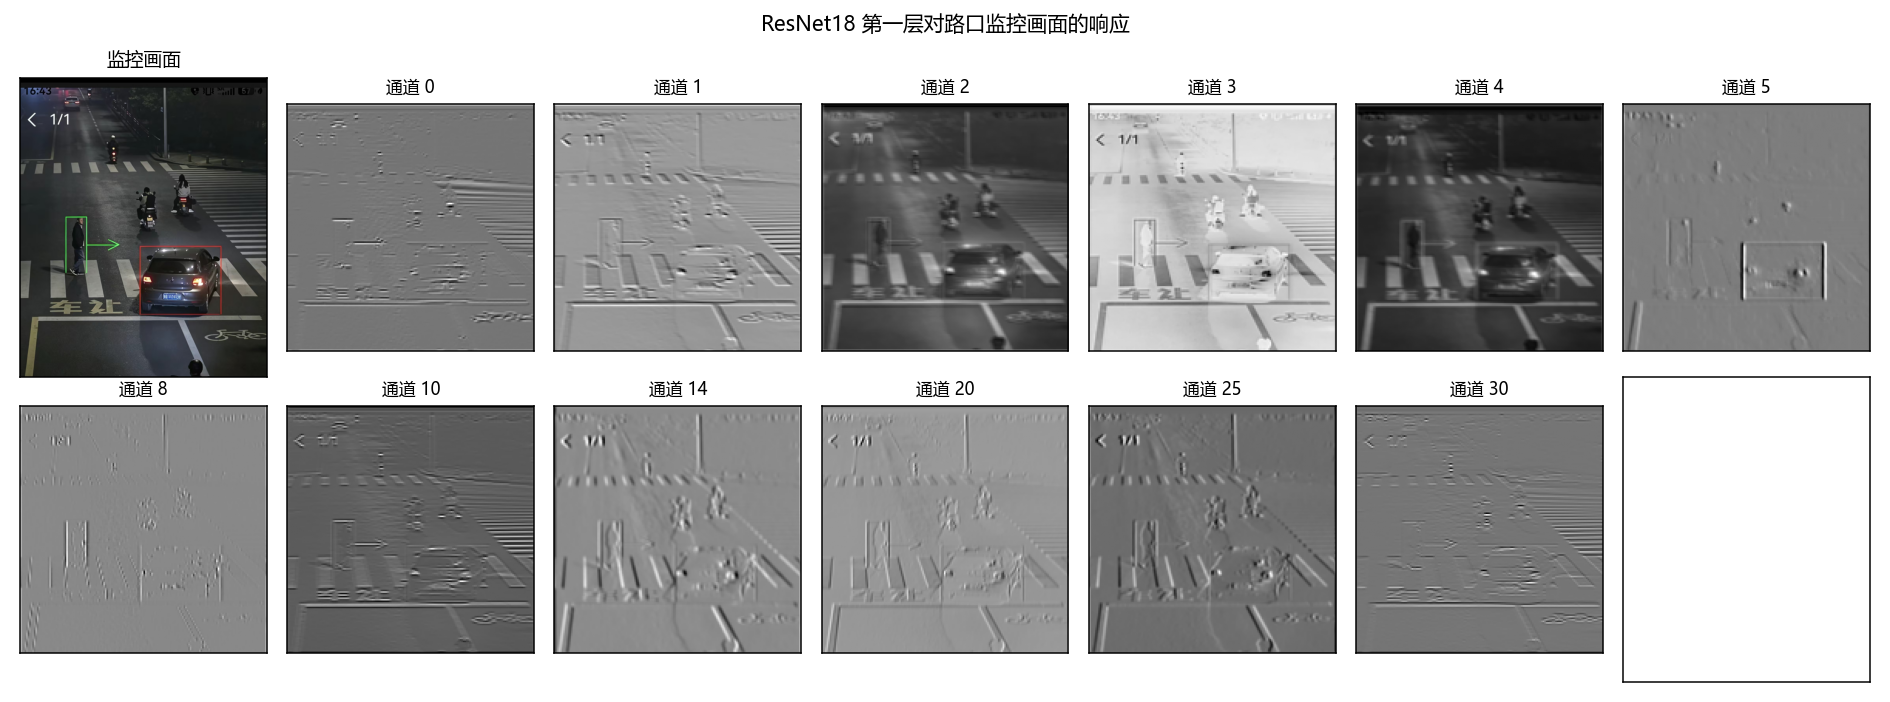
这 64 个核统计下来是什么样
我把它们逐个算了一遍梯度强度和通道差异,分成三类:
| 类型 | 数量 | 特征 |
|---|---|---|
| 强边缘型 | 21 / 64 | 梯度大、方向明确 |
| 强颜色型 | 19 / 64 | 三个通道形状差异大,在编码颜色 |
| 弱结构型 | 16 / 64 | 梯度弱,其中 8 个已经死掉 |
8 个死核的权重被压到 10-7 量级,L2 范数比活着的核小一千万倍。 原因是权重衰减每步都在把所有参数往 0 拉,而某个核如果输出长期落在 ReLU 负区间, 梯度恒为 0,就只剩衰减在起作用,跑够多轮就被磨没了。这跟前面说的「神经元死亡」是同一件事。
边缘核的方向分布也不均匀:峰值在 45° 和 135° 两条对角线,而不是水平和垂直。 因为真实图像里道路透视线、倾斜的车牌都是斜的,数据把最多的配额给了斜向。 手工设计 Sobel 只给横竖两个方向,是因为人按数学对称性做选择; 模型只看统计规律。
所以手工核和训练出来的核,本质是一回事:都是方向、边缘、颜色这些初级特征探测器。 差别在于手工核只有四个方向可选,训练出来的是从数据里统计出的最优解, 可能有几十种变体。这也解释了卷积层为什么要放几十上百个核—— 不是冗余,是每个核负责一种模式。
卷积层摊开来看,就是四个位置各拉成一行,乘同一个列向量。 全连接层每行的权重都不一样,卷积层用的是同一组。
但路网不适合用卷积
马永杰那篇列的五类应用——车牌、车型、交通标志、交通事件、交通状态—— 前四类本质都是图像识别。它们的数据是规则网格,每个像素和上下左右严格相邻、间距相等。 卷积核能这么滑,靠的就是这个前提。
路网不满足这个前提。路口之间有的连、有的不连,间距不一样,还有单行和转向限制。 如果把路网摊成方格子,等于假设所有相邻路口都等距、每个格子都恰好对应一个路口, 这个假设在真实城市里不成立。
更合适的表示是图:路口当节点,道路当边。 GNN(Graph Neural Network,图神经网络)直接在图上做消息传递, 每个节点从和它相连的邻居那里收信息,再更新自己的状态。 这跟卷积其实是一回事——都是从邻居聚合信息,区别只在邻居的定义: 卷积的邻居是「网格上上下左右的格子」,图卷积的邻居是「图上连着的那些点」。
所以这一阶段的方向判断是:CNN 用在交通里的图像类任务(车牌、标志、事件检测), 路网时空预测走 GNN。下周开始啃这部分。
可以点进去看细节
特征之后往哪走
卷积层只管提取,它本身不知道为什么任务服务。输出什么,取决于后面接什么。
| 任务 | 输出 | 对到哪 |
|---|---|---|
| 分类 | 一组概率 | 判断这是不是一辆车 |
| 检测 | 框的位置 + 类别 | 监控画面上的绿框红框 |
| 回归 | 一个数 | 下一小时流量 287 |
我这个方向是回归。输入 12 个小时的流量,输出下一个小时的一个数。 前面提特征的卷积和池化跟图像任务一样,区别只在最后不接 softmax,直接出数值。
这一路的所有数字,都建立在一个有问题的数据上。
下阶段计划
这周的结论只到「流程跑通、代码没错」。要往下走,第一步不是换模型,是把数据解决掉。
-
数据
把可用数据找到三条路:问老师有没有检测器数据;申请国家基础学科公共数据中心那套 (约 10GB,含信号交叉口);或者找公开的真实信号交叉口数据集。 这件事排最前面,没有数据后面都是空转。
-
文献
读两篇信号交叉口的论文田秀娟 2018《交叉口短时流量 CEEMDAN-PE-OSELM 预测模型》, 和 2025 年那篇 Urban Signalized Intersection Traffic State Prediction。 这两篇方向才对得上,马永杰那篇偏视觉识别。
-
实现
GNN 和 CNN 各写一遍不调现成库,从消息传递和卷积的前向、反向开始写。 目的不是产出,是理解。和数据申请冲突的话,先让给数据。
-
复现
选一篇能复现的论文等数据定下来再挑。优先选公开了数据的、只用历史流量就能跑的, 不追求逐位对上原文指标,能复现方法和趋势就行。
TOOLING
AI 参与:本页的 HTML 结构与样式、四个模型的实验代码、CityFlow 的检查脚本、 全部图表,由 Claude 生成并调试。
本人完成:文献阅读与圈注、电子笔记、纸质本整理、代码的本地运行与结果核对。 文中所有数字均取自实际运行输出,未作修饰。
共同完成:结论的组织与措辞,经与 Claude 讨论后确定。